
 Desde hace unos días ya tenemos disponible la versión 1.1.1 de KAI. En la entrada anterior comenté en en las posteriores actualizaría a versiones más actuales de KAI. Así que aprovecho para comentar algunas de las que incluye la versión y las pruebas de esta entrada y las siguientes las realizaré sobre esta versión actualizada (o posteriores). Adjunto este link a entrada en los blogs de Embarcadero donde se habla de la publicación de esta versión, por si queréis consultar algo más.
MEJORAS EN KAI 1.1.1
Mejor integración con modelos locales
El cambio más importante es la mejora de la compatibilidad y fiabilidad al utilizar modelos ejecutados localmente mediante Ollama y LM Studio. Embarcadero ha ampliado las pruebas con diferentes modelos y configuraciones, realizando ajustes para que KAI funcione de forma más consistente en entornos locales.
Mejor soporte para flujos «agentic»
Se ha optimizado la forma en que KAI envía a los modelos:
- Instrucciones del sistema.
- Herramientas disponibles (tool calling).
- Secuencias largas de llamadas a herramientas.
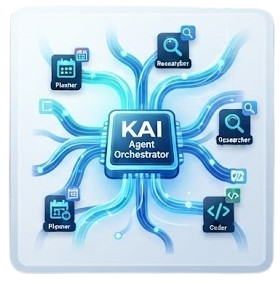
Esto mejora especialmente los escenarios donde KAI debe realizar varias acciones consecutivas, por ejemplo:
- Analizar un proyecto.
- Leer archivos fuente.
- Modificar código.
- Crear nuevos archivos.
- Compilar y corregir errores de forma iterativa.
Según Embarcadero, estos cambios aumentan la fiabilidad de los flujos de desarrollo asistidos por IA.
Correcciones y mejoras de calidad
Además de las mejoras relacionadas con modelos locales, KAI 1.1.1 incluye varios ajustes de usabilidad.
Una vez comentadas las mejoras, lo que voy a hacer en esta entrada, y ya que una de los cambios más importantes es el trabajo con modelos locales, voy a mostrar cómo configurar Ollama y LMStudio para trabajar en local, como configurarlo para trabajar con el IDE y veremos cómo funcionan ambas cosas y las mejoras que notamos (si es que las hay) con la anterior versión que vimos en la primera entrada de esta serie.
A nivel personal, si que he notado que la integración con el IDE es bastante mejor que en la versión 1.0 (que era la inicial). Más estable y con muchos menos problemas. La configuración también es más completa. Se respeta la configuración anterior (en mi caso Github copilot) y la interface del chat ha mejorado y se ve más clara.
TRABAJAR CON MODELOS LOCALES
Primero voy a centrarme en Ollama como modelo local y voy a seguir los pasos para poder utilizarlo. Antes de continuar (y para no dejarlo para el final) he de decir que para trabajar con modelos locales (las pruebas que he realizado con ambos) vamos a necesitar 2 cosas principalmente RAM y CPU. Me ha sorprendido la gran cantidad de recursos que estos modelos consumen y el tiempo de proceso alto en comparación con los modelos online. Por lo que he visto, aunque se puede trabajar, para poder sacer partido a estos modelos creo que vamos a tener que esperar un tiempo a que las máquinas mejoren en cuanto a potencia de proceso y velocidad.
Instalar y configurar Ollama
Empezamos instalando Ollama en nuestra máquina. Para ello descargamos el instalador de Windows desde la web oficial.
Una vez instalado Ollama, podemos comprobar si está «corriendo», ejecutando desde una línea de comandos:
Ollama -- versionCon esto obtendremos la versión de Ollama instalada
Ollama --version
Y con esto obtendremos los modelos instalados actualmente.
Ollama list
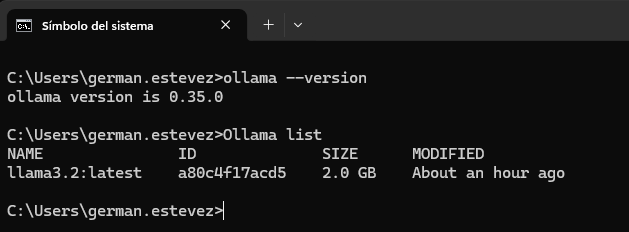
También podemos acceder desde un navegador a la URL por defecto en la instalación:
http://localhost:11434/
Instalar modelos en Ollama
Lo siguiente que necesitamos es instalar algún modelo en Ollama para poder trabajar con él. Yo por ahora he probado con Gemma, Llama y algunos de qwen.
Para instalar un modelo, basta con realizar un pull y el nombre del modelo que queremos instalar (desde línea de comandos).
Ollama pull gemma4
Ollama pull llama3.2
En nuestro caso parece que se recomienda qwen3-coder, así que para instalarlo utilizaremos el comando:
Ollama pull qwen3
Con estas 2 líneas, instalaremos estos 2 modelos. Si ahora ejecutamos el mismo comando de antes para visualizar los modelos instalados, debemos obtener que ambos están instalados.
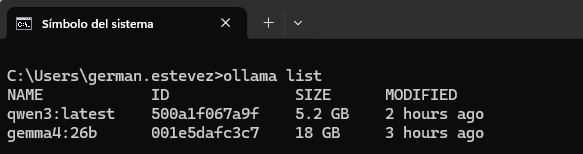
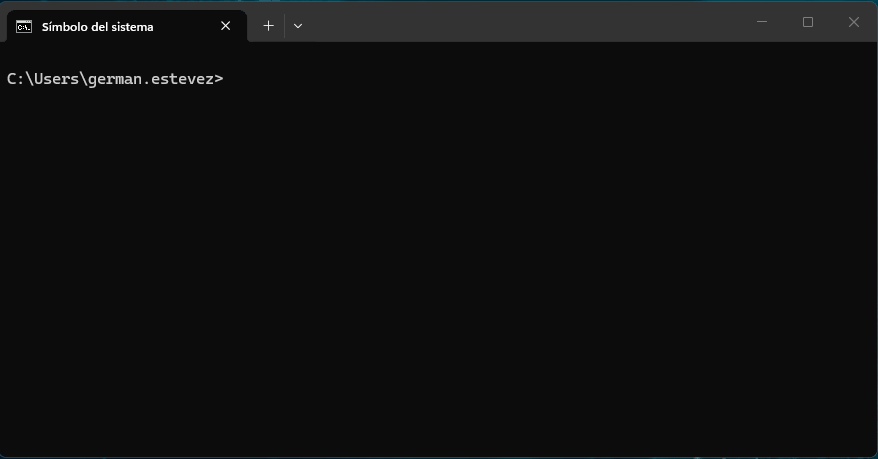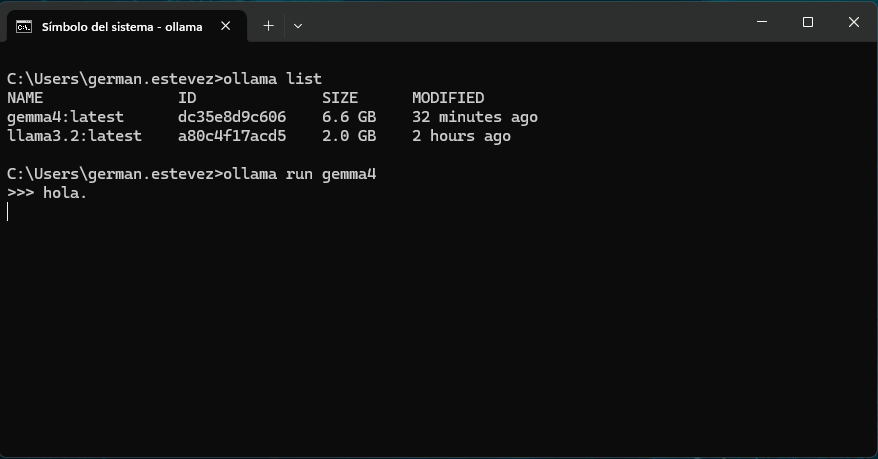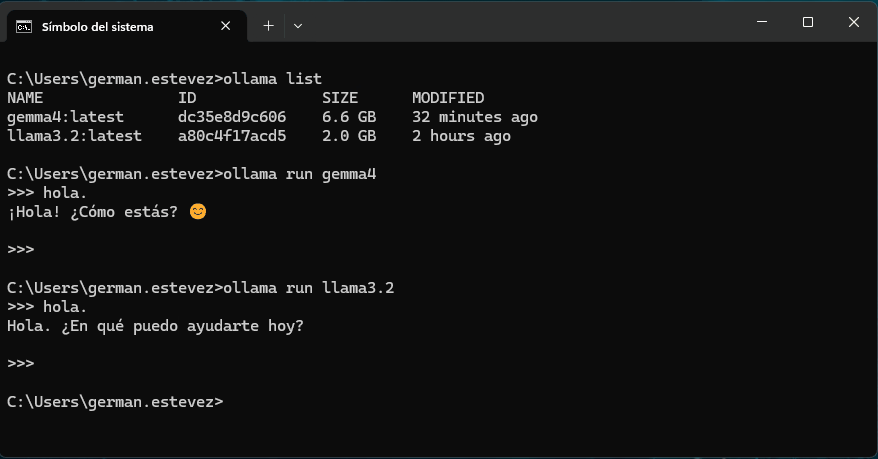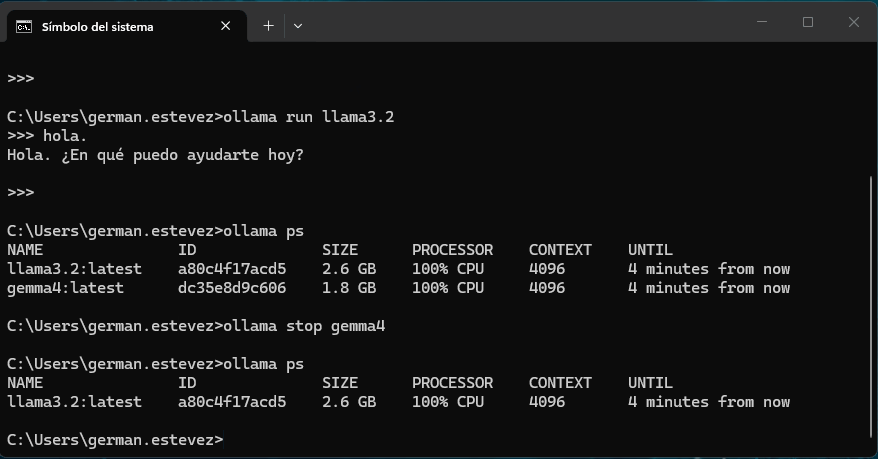
Podemos probar un modelo en local cargándolo (run) en memoria y preguntando algo. También podemos ver en cada momento los modelos cargados (ps) y descargarlos de memoria (stop).
Os dejo esta imagen donde podéis ver cómo funcionan los comandos.
Configurar Ollama y modelo en el IDE
Una vez que tenemos Ollama funcionando, vamos al IDE y configuramos el modelo local para trabajar. Tools/Options/KAI para acceder a la configuración.
Desde allí configuramos el modelo local, con la URL que hemos visto antes (http://localhost:11434/) y una vez comprobada la conexión, podremos escoger el modelo con el que queremos trabajar. Utilizamos el botón [Test connection] y una vez que la conexión se realice con éxito tendremos disponibles los modelos que hemos instalado anteriormente.
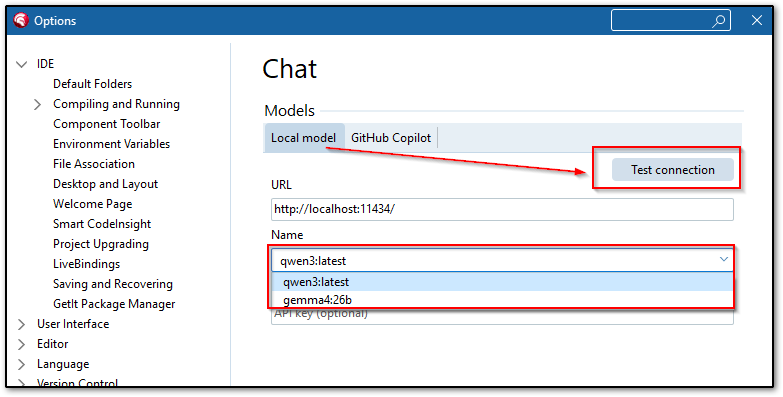
Una vez configurado el modelo, ya podemos abrir un chat y utilizarlo.
En el caso de LM Studio el procedimiento es similar.
Instalar LM Studio y Añadir modelos
Podemos descargar LM Studio desde el link oficial: https://lmstudio.ai/
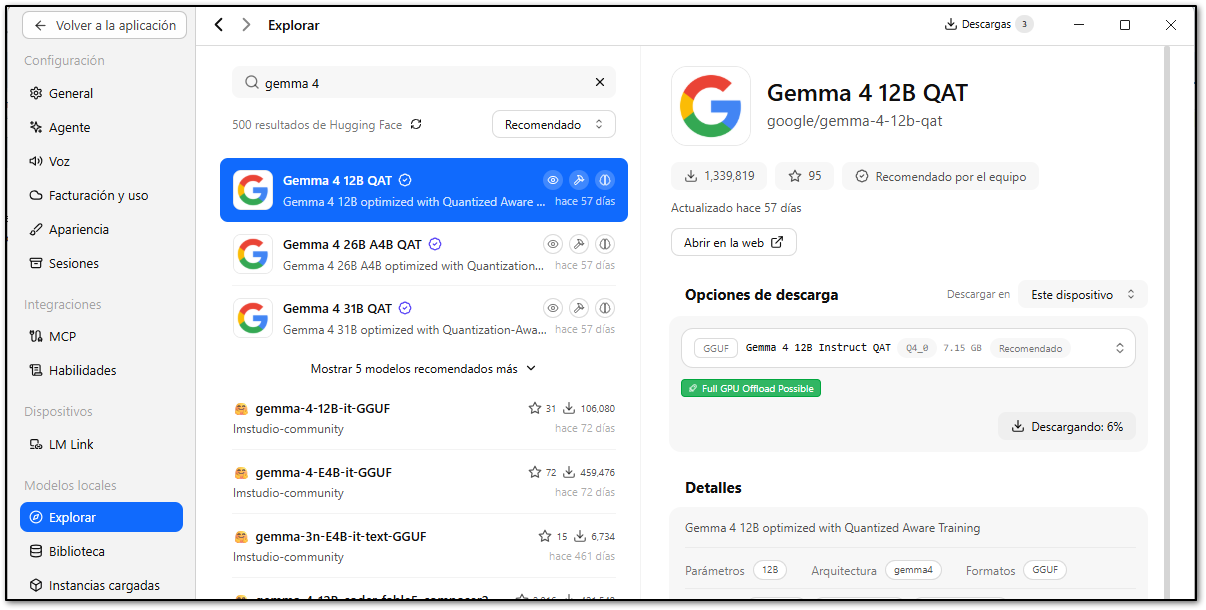
Una vez descargado e instalado, desde la configuración, en la sección «Explorar» podemos acceder a todos los modelos que podemos descargar. En concreto nos podemos centrar en el modelo Gemma 4 12B (compatible) y como vemos en la imagen inferior.
Necesitamos acceder a la sección de «API para modelos locales» y activar el «Servidor de API Local». En ese punto obtendremos la URL para acceder y que posteriormente usaremos en el IDE de Delphi (por defecto http://localhost:1234/v1).
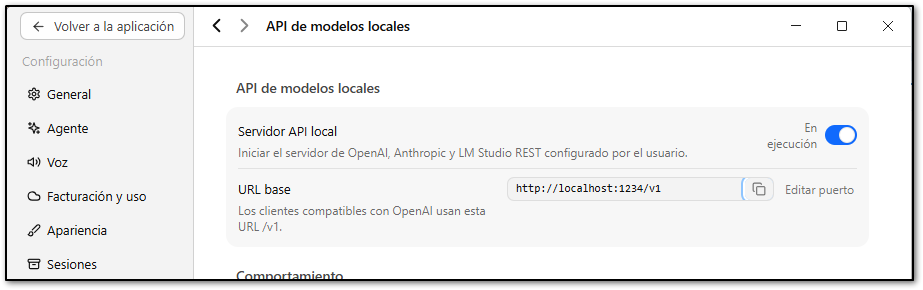
En este punto ya podemos acceder desde un navegador y probar si tenemos acceso a LM Studio, con la URL que hemos configurado en el punto anterior.
Configurar LM Studio en el IDE
Una vez que ya tenemos LM Studio y el modelo instalador y funcionando, la configuración desde el IDE es muy similar a la de Ollama (es realidad es la misma). Desde la configuración de KAI, configuramos el modelo local con la URL anterior de la API del modelo (http://localhost:1234/v1) y una vez testada la conexión, ya tendremos en el desplegable los modelos instalados.
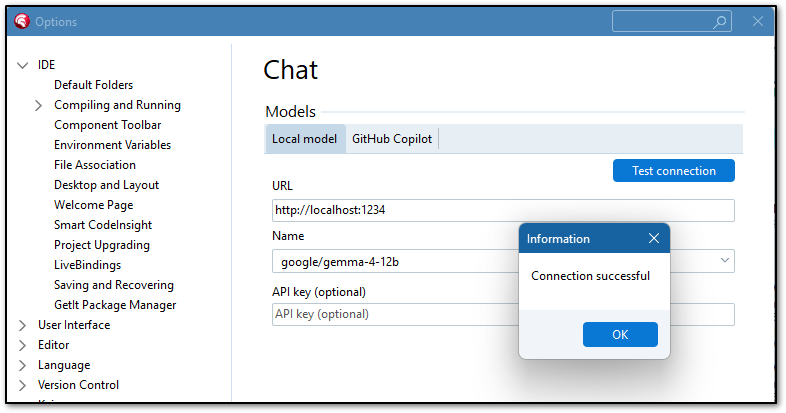
Si hemos llegado hasta aquí, ya podemos abrir un chat en el IDE de Delphi y escribir lo que necesitemos.
Hasta aquí esta entrada, en las próximas continuaré evaluando la integración con el IDE de Delphi.
Como siempre sugerencias, comentarios, y demás son bienvenidos. Hasta la próxima!

Embarcadero MVP.
Analista y Programador de Sistemas Informáticos.
Estudios de Informática (Ingeniería Técnica Superior) en la UPC (Universidad Politécnica de Barcelona).
Llevo utilizando Delphi desde su versión 3. Especialista en diseño de componentes, Bases de Datos, Frameworks de Persistencia, Integración Continua, Desarrollo móvil,…
